Blog Host Group
Fique por dentro das últimas novidades sobre hospedagem, tecnologia e dicas para seu negócio digital.
Fique por dentro das últimas novidades sobre hospedagem, tecnologia e dicas para seu negócio digital.
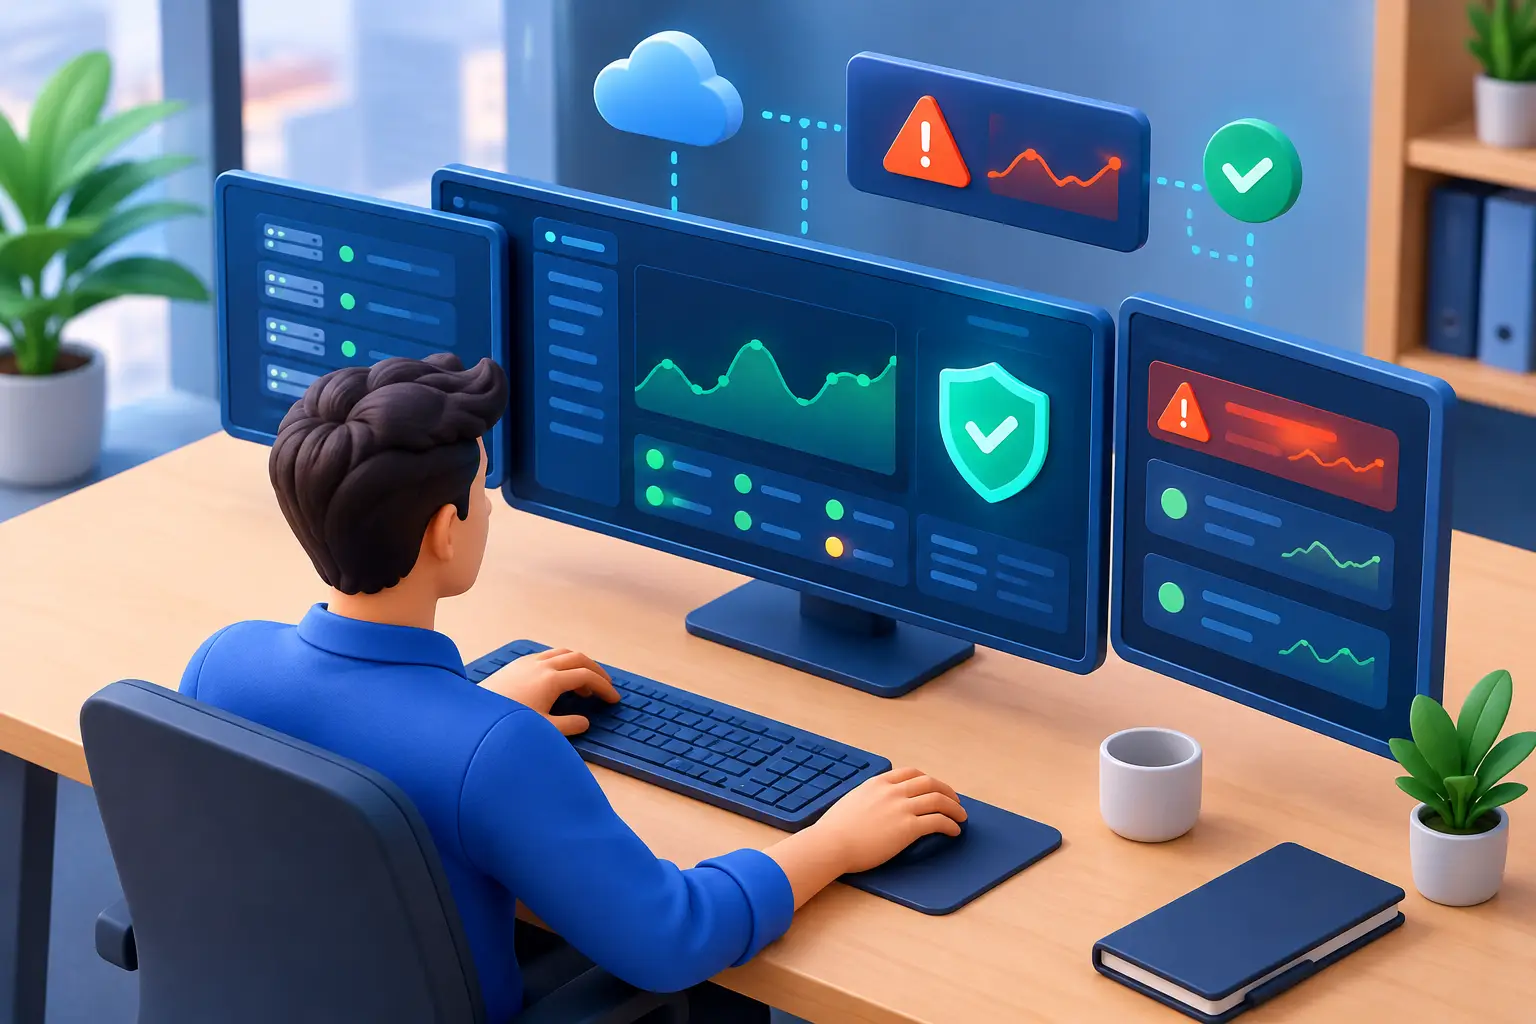
Um exemplo de monitoramento proativo começa antes de o cliente perceber qualquer problema. Uma loja virtual pode estar com o site aparentemente no ar, mas já apresentar lentidão no checkout, aumento de erros no banco de dados ou consumo anormal de memória. Se ninguém identificar esses sinais, a falha deixa de ser uma possibilidade técnica e passa a afetar vendas, atendimento e reputação.
Monitorar de forma proativa é acompanhar indicadores que revelam a saúde da infraestrutura e agir quando eles fogem do padrão. Não se trata apenas de receber uma mensagem dizendo que o site caiu. O objetivo é detectar a condição que pode causar a indisponibilidade, corrigir a causa e manter a operação disponível.
O monitoramento reativo entra em cena depois do incidente. O time recebe um chamado, percebe que uma página não abre ou que o aplicativo ficou inacessível e então inicia a investigação. Esse modelo resolve problemas, mas deixa o negócio exposto ao período entre a falha e a resposta.
Já o acompanhamento proativo usa métricas, testes e alertas para identificar desvios antes que eles se transformem em parada. Um alerta de uso de disco acima de 85%, por exemplo, dá tempo para revisar arquivos, logs, backups e capacidade de armazenamento antes que o servidor fique sem espaço e interrompa serviços essenciais.
Para quem administra um site institucional, uma loja virtual, uma aplicação em NodeJS ou uma plataforma em Python, essa diferença é direta: menos interrupções, menor risco de perda de dados e mais previsibilidade para crescer. O tipo de monitoramento varia conforme a operação, mas disponibilidade, desempenho, segurança e capacidade são pontos básicos em qualquer ambiente.
Imagine uma loja que recebe grande parte dos pedidos entre 10h e 14h. O ambiente hospeda o site, o banco de dados, integrações de pagamento, envio de e-mails transacionais e um painel administrativo. Em uma manhã de campanha, o número de acessos cresce rapidamente.
Um sistema de monitoramento acompanha, em intervalos definidos, o tempo de resposta das páginas principais, o uso de CPU, memória e disco, a quantidade de conexões ao banco de dados, a disponibilidade do certificado SSL e os códigos de resposta HTTP. Ele também verifica se o checkout pode ser acessado e se a aplicação responde a uma requisição real.
Às 10h20, a ferramenta detecta que o tempo de resposta do checkout subiu de 400 milissegundos para 2,8 segundos. Ao mesmo tempo, o uso de CPU passa de 45% para 82%, e o número de conexões simultâneas com o banco cresce acima da média. A loja ainda está online, porém os indicadores mostram que a experiência do usuário está se deteriorando.
O alerta chega à equipe responsável com o contexto necessário: horário, servidor afetado, métrica, limite configurado e histórico recente. Em vez de aguardar a reclamação de um comprador, o time verifica um processo de importação de produtos iniciado no mesmo horário da campanha. O processo está executando consultas pesadas no banco de dados.
A equipe interrompe a tarefa, agenda a importação para uma janela de menor tráfego e otimiza as consultas usadas pelo sistema. Se a capacidade continuar próxima do limite, a operação pode ampliar recursos em cloud ou migrar partes críticas para uma infraestrutura dedicada. O cliente não encontra uma página fora do ar, e a empresa evita que um pico previsível resulte em carrinhos abandonados.
Esse é o valor prático do monitoramento proativo: transformar sinais técnicos em decisões rápidas. O alerta, sozinho, não resolve o problema. Ele encurta o caminho entre o risco e a ação adequada.
Nesse cenário, cada métrica responde a uma pergunta operacional. O tempo de resposta mostra se o visitante consegue navegar com agilidade. CPU e memória indicam pressão sobre os recursos do servidor. O uso de disco evita que arquivos temporários, logs ou backups ocupem toda a capacidade disponível.
As conexões e o tempo de execução das consultas ajudam a identificar gargalos no banco de dados. Já os códigos HTTP, como erros 500, revelam falhas da aplicação que podem não derrubar o servidor inteiro, mas impedem etapas essenciais, como login, pagamento ou envio de formulário.
Também vale monitorar a validade do SSL, a resolução do domínio, a integridade de backups e tentativas anormais de acesso. Esses pontos protegem a continuidade da operação por ângulos diferentes. Um certificado vencido, por exemplo, pode gerar alertas no navegador e afastar visitantes, mesmo que o servidor esteja funcionando normalmente.
O primeiro passo é definir o que não pode parar. Para uma clínica, pode ser o formulário de agendamento. Para uma agência, pode ser o acesso aos sites de clientes. Para uma empresa de software, pode ser a API que atende o aplicativo. Não existe uma lista universal de prioridades: o monitoramento precisa refletir o impacto real de cada serviço no negócio.
Em seguida, estabeleça uma linha de base. Antes de definir que 70% de CPU é um alerta crítico, observe como o ambiente se comporta em dias comuns, horários de pico e períodos de campanha. Um servidor pode operar bem com uso elevado por alguns minutos, mas permanecer nesse nível por muito tempo pode indicar saturação ou crescimento sem planejamento.
Os limites também devem ter níveis. Um aviso pode ser enviado quando o disco atingir 75%, permitindo análise sem urgência. Um alerta de atenção pode ocorrer em 85%. Ao alcançar 95%, a equipe deve ter um procedimento imediato. Essa gradação reduz alarmes desnecessários e ajuda a priorizar o que exige ação.
O canal de aviso importa tanto quanto a métrica. Alertas críticos enviados apenas por e-mail podem ficar sem resposta durante uma madrugada ou feriado. Operações que precisam de disponibilidade contínua devem definir responsáveis, escalonamento e canais capazes de gerar reação rápida. Suporte especializado 24/7 faz diferença quando a falha acontece fora do horário comercial.
Por fim, documente a resposta esperada. Se o banco de dados apresentar lentidão, quem verifica os processos? Se o SSL estiver próximo do vencimento, quem renova? Se a capacidade estiver no limite, quando é hora de ampliar o plano ou adotar um servidor dedicado? Um alerta sem responsável e sem procedimento só transfere a urgência para mais tarde.
Acompanhar o ambiente não corrige uma infraestrutura subdimensionada. Se uma aplicação cresce e precisa de mais processamento, memória ou isolamento, o monitoramento mostrará esse padrão, mas a empresa ainda precisará tomar uma decisão de capacidade. Hospedagem compartilhada atende muitos projetos com eficiência, enquanto cloud e servidores dedicados podem ser mais adequados para cargas variáveis, aplicações críticas ou necessidades de recursos exclusivos.
Há também um limite para o que pode ser antecipado. Uma falha externa em um provedor de pagamento, um erro introduzido em uma atualização de código ou um ataque de grande escala podem causar impacto mesmo com alertas bem configurados. Por isso, o monitoramento deve trabalhar junto com backups periódicos, firewall, atualizações, controle de acesso e testes de recuperação.
Outro cuidado é evitar excesso de notificações. Quando tudo gera alerta, os avisos realmente relevantes se perdem. Métricas devem ser revisadas ao longo do tempo, principalmente após mudanças de tráfego, lançamento de novos recursos ou migração de infraestrutura. A qualidade do monitoramento está mais na relevância dos sinais do que na quantidade de gráficos disponíveis.
Se os alertas apontam picos recorrentes de CPU, pouca memória livre, crescimento acelerado de banco de dados ou lentidão nos horários mais rentáveis, a empresa não deve esperar uma interrupção para agir. Esses dados servem para planejar a expansão com segurança e justificar tecnicamente o investimento.
Uma estrutura com armazenamento NVMe, recursos escaláveis, backups e monitoramento reduz pontos de atrito na administração diária. Para negócios que precisam manter sites, e-mails, domínios e aplicações sob controle, centralizar esses elementos também facilita a identificação de falhas e a comunicação com o suporte.
A Host Group oferece infraestrutura para diferentes estágios da operação, desde hospedagem de sites até cloud computing e servidores dedicados, com atendimento em português e suporte especializado 24/7. O ponto decisivo é escolher recursos compatíveis com a carga atual e com o próximo passo do negócio.
Monitorar não é esperar uma tela de erro para começar a cuidar do ambiente. É criar visibilidade para agir cedo, preservar a confiança de quem acessa seu site e manter cada serviço disponível quando ele mais importa.

Autor na Host Group, compartilhando conhecimento sobre hospedagem e tecnologia.
Ver todos os posts