Blog Host Group
Fique por dentro das últimas novidades sobre hospedagem, tecnologia e dicas para seu negócio digital.
Fique por dentro das últimas novidades sobre hospedagem, tecnologia e dicas para seu negócio digital.
Uma loja virtual fora do ar em horário de venda, um sistema que não responde no fechamento do mês ou um e-mail corporativo indisponível pode gerar perdas que vão além da receita imediata. Há impacto na confiança, no atendimento e na produtividade da equipe. É nesse cenário que a alta disponibilidade cloud deixa de ser um detalhe técnico e passa a ser uma decisão de continuidade para o negócio.
Ter um site publicado não é o mesmo que ter uma operação preparada para falhas. Servidores, redes, bancos de dados e aplicações podem apresentar problemas por manutenção, picos de acesso, erro humano, falha de hardware ou incidentes externos. A diferença está em quanto tempo a operação fica indisponível e na capacidade de continuar atendendo mesmo quando uma parte da infraestrutura falha.
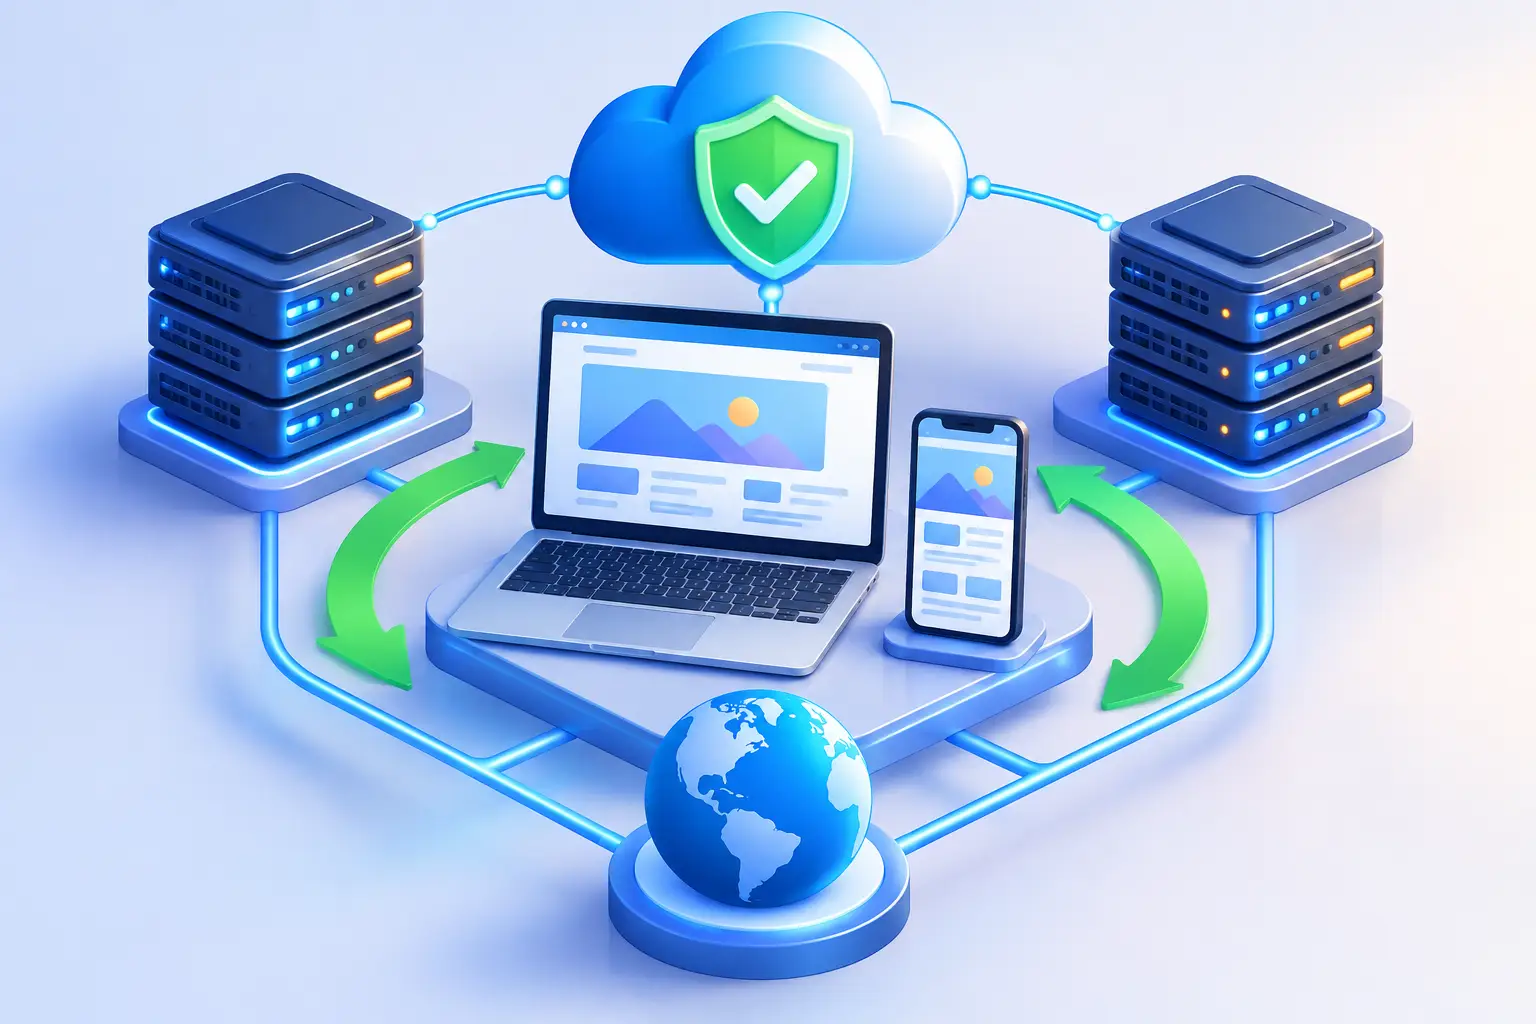
Alta disponibilidade é a capacidade de manter um serviço acessível pelo maior tempo possível, com interrupções mínimas e controladas. No ambiente cloud, ela é construída com recursos distribuídos, monitoramento e mecanismos que reduzem a dependência de um único servidor, disco ou conexão de rede.
Na prática, uma arquitetura de alta disponibilidade pode direcionar o tráfego para outra instância quando uma máquina apresenta falha, manter cópias sincronizadas de dados ou distribuir acessos entre vários recursos. O usuário final, idealmente, continua navegando, comprando ou utilizando o aplicativo sem perceber uma indisponibilidade pontual na camada de infraestrutura.
Isso não significa prometer ausência absoluta de falhas. Nenhum ambiente elimina todos os riscos. O objetivo é evitar que uma falha isolada interrompa toda a operação e reduzir o tempo necessário para recuperar serviços críticos.
Esses três conceitos trabalham juntos, mas resolvem problemas diferentes. Alta disponibilidade busca manter o serviço ativo durante uma falha. Backup preserva uma cópia de arquivos, bancos de dados e configurações para restauração posterior. Recuperação de desastre define como a empresa volta a operar após um evento mais grave, como corrupção de dados, ataque ou perda de uma região inteira.
Um backup diário é essencial, mas não impede que uma aplicação fique indisponível até que alguém identifique o problema e restaure os dados. Da mesma forma, servidores redundantes não resolvem a exclusão acidental de informações se essa exclusão for replicada entre os ambientes. Uma estratégia consistente combina disponibilidade, backups periódicos testados e procedimentos claros de recuperação.
A base de uma operação mais disponível é remover pontos únicos de falha. Se todo o site depende de uma única máquina, de um único banco de dados ou de uma única conexão, qualquer problema nesse componente pode interromper o serviço. Em cloud, é possível organizar recursos de forma distribuída e escalar conforme o comportamento da demanda.
O balanceamento de carga é um exemplo. Ele distribui as solicitações entre múltiplas instâncias da aplicação. Se uma delas ficar indisponível, as demais podem assumir os acessos. Para funcionar bem, esse processo precisa de verificações de saúde, conhecidas como health checks, que identificam se a instância responde de fato e não apenas se está ligada.
O banco de dados exige atenção especial, pois costuma concentrar transações, cadastros, pedidos e informações estratégicas. Réplicas, mecanismos de failover e rotinas de backup ajudam a reduzir risco, mas a escolha depende do perfil da aplicação. Uma loja virtual com pedidos constantes e um site institucional têm necessidades diferentes de consistência, desempenho e custo.
Também é necessário pensar em arquivos estáticos, sessões de usuários e DNS. Se imagens, documentos ou sessões estiverem presos a uma única instância, a troca automática de servidor pode falhar ou gerar perda de contexto para o usuário. Armazenamento compartilhado, cache bem configurado e sessões externas são alternativas comuns em projetos que exigem maior continuidade.
O uptime é normalmente expresso em percentual. Um índice de 99,9% de disponibilidade permite cerca de 8 horas e 45 minutos de indisponibilidade ao longo de um ano. Já 99,99% reduz essa margem para aproximadamente 53 minutos anuais. A diferença parece pequena no percentual, mas pode ser relevante para operações que vendem ou atendem continuamente.
Ainda assim, o percentual isolado não deve ser o único critério. É preciso entender o que está coberto: servidor, rede, infraestrutura física, aplicação ou suporte? Uma aplicação com código mal otimizado, consultas lentas ao banco de dados e integrações externas instáveis pode apresentar falhas mesmo em uma infraestrutura com alto índice de disponibilidade.
Por isso, o acordo de nível de serviço deve ser avaliado junto com monitoramento, tempo de resposta do suporte e processos de manutenção. Para muitos pequenos e médios negócios, uma hospedagem com uptime de 99,9%, backups, firewall e suporte especializado 24/7 já oferece uma base eficiente. Projetos com impacto financeiro elevado por minuto de parada podem precisar de uma arquitetura cloud com redundância mais ampla.
A decisão deve partir do impacto real de uma indisponibilidade. Se o site é uma vitrine institucional com atualizações pontuais, recursos básicos de hospedagem, proteção e backup podem atender bem. Se a empresa depende de vendas online, portal de clientes, APIs, sistema de agendamento ou aplicação usada por equipes internas, a tolerância a paradas tende a ser menor.
Alguns sinais indicam que é hora de avaliar alta disponibilidade cloud com mais profundidade:
A escalabilidade é parte importante desse cenário. Alta disponibilidade mantém o serviço acessível diante de falhas. Escalabilidade permite aumentar ou reduzir recursos para acompanhar a demanda. Uma campanha promocional, por exemplo, pode exigir mais capacidade de processamento e memória mesmo que nenhum componente apresente defeito.
A tecnologia só entrega continuidade quando existe planejamento. O primeiro passo é mapear quais serviços são críticos: site, e-mails, banco de dados, painel do cliente, integrações de pagamento, APIs e arquivos. Em seguida, defina quanto tempo cada serviço pode ficar indisponível e qual volume de dados pode ser perdido sem causar prejuízo relevante.
Essas métricas são conhecidas como RTO, tempo objetivo de recuperação, e RPO, ponto objetivo de recuperação. Um RTO de uma hora significa que o serviço deve voltar a operar em até uma hora após um incidente. Um RPO de 15 minutos indica que a empresa aceita perder, no máximo, dados produzidos nos 15 minutos anteriores ao problema. Quanto menores esses tempos, maior tende a ser a complexidade e o investimento necessário.
Monitoramento contínuo também é indispensável. Não basta saber que o servidor está acessível. É preciso acompanhar uso de CPU, memória, armazenamento, erros da aplicação, tempo de resposta, disponibilidade do banco de dados e validade de certificados SSL. Alertas bem configurados permitem agir antes que a lentidão vire uma interrupção percebida pelos clientes.
Testes fecham o ciclo. Restaurar backups, simular falhas e revisar procedimentos mostram se a arquitetura funciona fora do papel. Um plano que nunca foi testado pode falhar justamente quando a equipe mais precisa dele. Documentação simples, responsáveis definidos e acesso seguro às ferramentas tornam a resposta mais rápida.
Para empresas brasileiras, a localização da infraestrutura pode influenciar a latência, o suporte e a previsibilidade da operação. Data center no Brasil tende a reduzir o tempo de resposta para usuários locais, especialmente em sistemas com muitas interações. Também facilita o atendimento em português e a comunicação durante incidentes.
A Host Group reúne hospedagem, cloud, servidores dedicados, domínios e suporte técnico em uma operação centralizada. Essa combinação ajuda empresas e agências a evoluir a infraestrutura conforme o projeto cresce, sem perder visibilidade sobre os serviços que sustentam a presença digital.
Alta disponibilidade não precisa começar com uma estrutura complexa. Comece identificando o que sua operação não pode deixar de entregar, escolha recursos compatíveis com esse nível de exigência e mantenha backups, monitoramento e suporte preparados. Seu site sempre online é resultado de decisões técnicas feitas antes do próximo acesso, da próxima venda e da próxima falha.

Autor na Host Group, compartilhando conhecimento sobre hospedagem e tecnologia.
Ver todos os posts